Hello,大家好我是梅森Mason,今天我要帶各位來分析HTML原始碼。
首先,我們先把前天所爬回的原始碼檔案打開(還沒看過的點→me←)

接著,在原始碼中找尋有關於成語的內容,各位應該會找到以下內容,觀察一下,你發現了什麼?
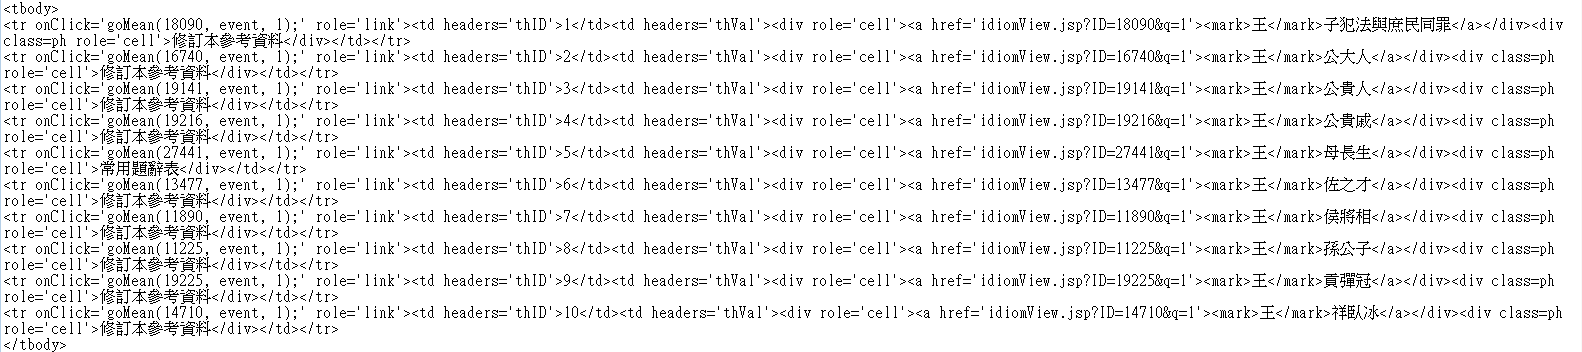
各位可能會發現成語摻雜在許多複雜的原始碼中,其實細心觀察後,你會發現,你面其實由許多像是這樣的標籤組成(看下一行)。
<標籤>內容</標籤>
你會發現,跟之前學得好像有幾分相似(還沒看過的點→me←),在經過我的分析之後,每行原始碼之中只有成語這行有
這個標籤,因此排除其他行之後,只剩下有成語的這幾行,而每行都可以分為前後兩組原始碼(見下圖)。
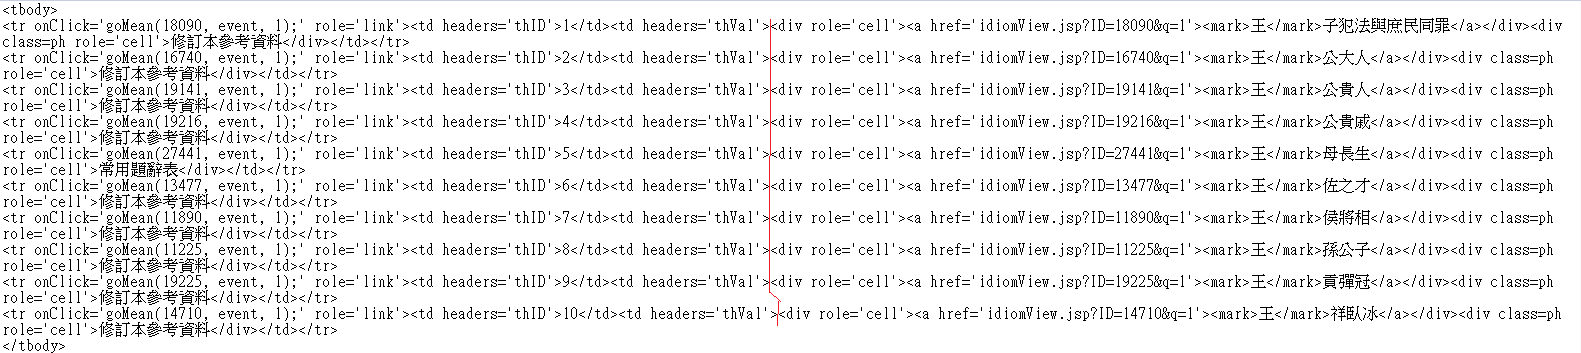
因此只要將後半部留下來,前半部刪除,而這點在
做得到。
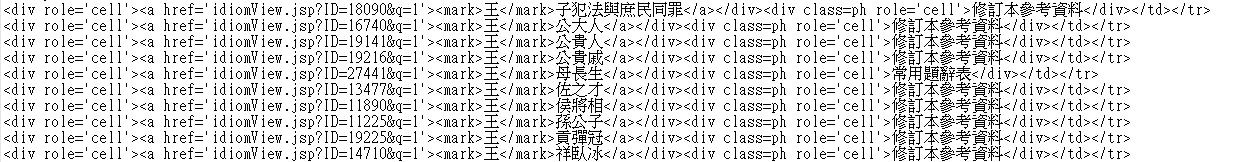
那剩下就只要將所有標籤刪除,明天就會教大家如何用程式刪除標籤囉!
希望這些課程能給各位讀者大大幫助,歡迎把本文轉發,讓更多人知道喲!
By 那個成天泡在電腦裡的梅森 on May 23, 2021.
§ NEXT
推薦文章
§ SUBSCRIBE
訂閱新文章
用 GitHub 帳號訂閱。每發一篇新文章,我會在 Discussions 開一則公告,GitHub 就會寄信到你的信箱——你不用把 email 交給我,也隨時可以自己取消。那則公告同時就是這篇文章的留言區。
- 01開啟下面的 repo(需要登入 GitHub)
- 02按右上角的 Watch
- 03選 Custom,勾 Discussions,按 Apply
COMMENTS